我的 AI Coding 工作流(四):感悟篇
这一篇不再讲具体 Skill,也不列工具清单,只写这段时间反复遇到、现在仍然认可的几条看法。
这些看法来自把真实开发任务长期交给 Coding Agent 的经验。模型和 Runtime 还在快速变化,结论以后大概率还会变。
系列文章:
早期我也会花很多时间改 Prompt,希望通过一句更精确的指令让结果突然稳定下来,后来任务越来越复杂,我才发现影响结果的东西还包括项目规则有没有读到、相关代码是不是完整、调用关系有没有查到、历史决策是否还有效、验收标准是否明确。
Prompt 能改变模型这一次如何理解任务,却无法补上缺失的项目事实,所以现在遇到 Agent 表现差,我会先查上下文,而不是立刻重写提示词,先确认它到底看到了什么、缺了哪份项目规则、有没有读错旧文档,以及是不是只看到了报错行,却没拿到状态来源和调用链。
很多所谓的“模型突然降智”,查到最后只是它在一份残缺上下文上努力推理,这不是模型突然变了,而是输入给它的事实不完整。
同一个模型放进不同 Coding Agent,体验可以差很多。模型本身决定了推理、代码理解和生成能力的大致上限,但真实任务还要经过上下文构造、工具调用、权限控制、Shell、文件系统、任务状态、暂停恢复、错误处理和验证反馈,这些都属于 Runtime / Harness 和工程环境。
所以我现在不会只问“哪个模型更强”,还会重点看以下几件事:
- 长任务中断以后能不能可靠恢复
- 工具结果会不会丢
- session 压缩以后关键事实是否还能回读
- worktree 和权限边界是否清楚
- Runtime 有没有 Goal / task persistence
- 修改以后能不能方便地拿到测试、diff 和运行时证据
一个强模型如果长期在错误上下文里工作,或者任务一中断就丢状态,工程结果仍然不会稳定,这也是我现在设计 Skills 时尽量复用 Runtime 原生能力的原因。Runtime 已经能管理 Goal、pause、resume 和 recovery,就不再在 Skill 里复制第二套生命周期系统。
多个 Agent 给出同一个答案,看起来很有说服力,但如果它们共享了同一份错误前提,只会更一致地犯错。
我现在真正愿意使用多 Agent 的场景,通常有这些:
- 一个 Agent 独立调查,不提前看主 Agent 的结论
- 实现者和审查者分开,避免自己验证自己
- 不同垂直切片放在独立 worktree 中实现
- 对高风险设计让不同模型分别给意见,再由主 Agent 合并证据
我不太喜欢让很多 Agent 围绕同一条核心调用链同时修改代码。公共配置、共享类型、依赖注入和架构边界本来就需要统一把关,增加并行度反而容易制造合并问题。
我看重多 Agent,主要因为独立上下文能带来额外证据,职责隔离也能减少实现和验证之间的互相影响。
我现在很喜欢 Automation,但不会因为一个任务“每周都要做”就立刻自动化。一个流程如果还在频繁变,自动化以后只是定期执行一套尚未验证的规则。真正适合无人值守的任务最好满足这些条件:
- 输入范围稳定
- 允许做什么非常明确
- 能分清成功还是失败
- 输出可以复查
- 风险有限,失败不会直接造成不可逆结果
每日 commit 审查、周报、代码健康检查、资料整理都比较符合这些条件。需求取舍、生产发布、删除数据和高风险改造,我仍然希望人留在决策点上。Automation 最后还要留下 evidence,只收到一句“任务执行成功”,其实不知道它检查了什么、跳过了什么,也不知道中间有没有失败。
长期 Memory 很方便,但工程场景里也很容易把旧事实带进新任务,我愿意长期保存的只是稳定信息,例如项目约定、个人偏好、已经反复验证的命令和容易踩坑的边界。
下面这些内容,我更愿意每次现场确认:
- 当前分支和 worktree 状态
- 服务是否在线
- SDK 和外部 API 的当前版本行为
- 某个 Bug 的根因
- 某项功能到底有没有发布
Memory 可以帮助 Agent 快速找到方向,但不能替代当前仓库、当前文档和当前运行结果,如果一条信息会随着时间变化,就不应该因为“模型记得”而自动升级成事实。
我一直偏好最小改动,但这句话很容易被误解成“少读代码”。真正的最小改动建立在充分理解之上,要先知道入口在哪里、状态从哪里来、有哪些相邻调用路径、共享逻辑由谁负责,才能找到最小且正确的修改点。如果只是为了让 diff 看起来小,看到报错行就在附近加一个条件,很可能只是把问题藏到了下一条路径。我更希望 Agent 先把问题看完整,再用尽量少的代码解决它,调查可以很深,最终 diff 仍然可以很小,这两件事并不冲突。
长期使用 Coding Agent 后,我开始频繁遇到另一类问题:代码没有明显 Bug,甚至写得很“规范”,但维护成本越来越高。
典型例子包括大量为了测试而存在的 injection point、多层 wrapper、没有真实使用者的 adapter、临时 debug hook、已经失去意义的 compatibility path,以及 AI 主动补出来的各种可扩展设计。
这些代码通常不是垃圾,它们当时甚至都有理由存在。问题在于生产 ownership 已经消失,维护义务却留了下来。
所以我现在会周期性地做 simplify Survey,不管代码是谁写的,也不因为抽象多就删,而是重新确认这些复杂度今天还有没有真实使用者。
AI Coding 把“生成代码”的成本降得很低以后,删除不再需要的代码反而变成更重要的工程能力。
“已经完成”“测试通过”“没有问题”这些句子,我现在都会下意识地问,证据在哪里?我会看代码和 Git diff、真实测试输出、构建、日志、浏览器、真机或接口响应。另一个 Agent 的 review 也只是一份意见,不能自动替代这些东西。
软件工程本来就需要可复查的状态,模型的自我汇报也应该接受同样的检查,Agent 很适合帮助我们更快地收集、组织和检查证据,但它自己的总结不能成为最终证据来源。
复杂任务做久以后,我不再把全部状态留在一条对话里,因为对话会压缩、会中断,也会混入大量已经失效的探索过程。长期任务更需要职责清楚、能重新读取的本地产物:决策放决策文件,需求规范放 SPEC.md,多处实现要共同遵守的设计约定在需要时放进 HLD.md,执行图放 tickets,当前状态交给 Runtime 或执行证据。
这样下一轮 Agent 不需要“回忆我们之前聊到哪了”,只需要读取当前有效的本地产物,对我来说,Context Engineering 很重要的一部分,就是把应该长期存在的信息从聊天记录里拿出来,让它有明确 owner 和生命周期。
Coding Agent 现在已经能调查、修改、验证、审查,甚至可以在一段时间里持续推进任务,很多以前必须手动执行的操作确实已经可以交出去。
但我仍然不会把下面这些责任交给模型自动决定:
- 需求到底值不值得做
- 哪个风险可以接受
- 是否应该引入长期维护成本
- 是否允许执行生产操作
- 一个证据是否足以支撑对外承诺
AI 可以替我做不少重复执行,目标取舍、风险接受和最终责任仍然需要人承担。写代码越来越快以后,我花时间更多的地方其实是需求有没有想清楚、边界有没有定义好、证据够不够,以及这段代码到底值不值得存在。
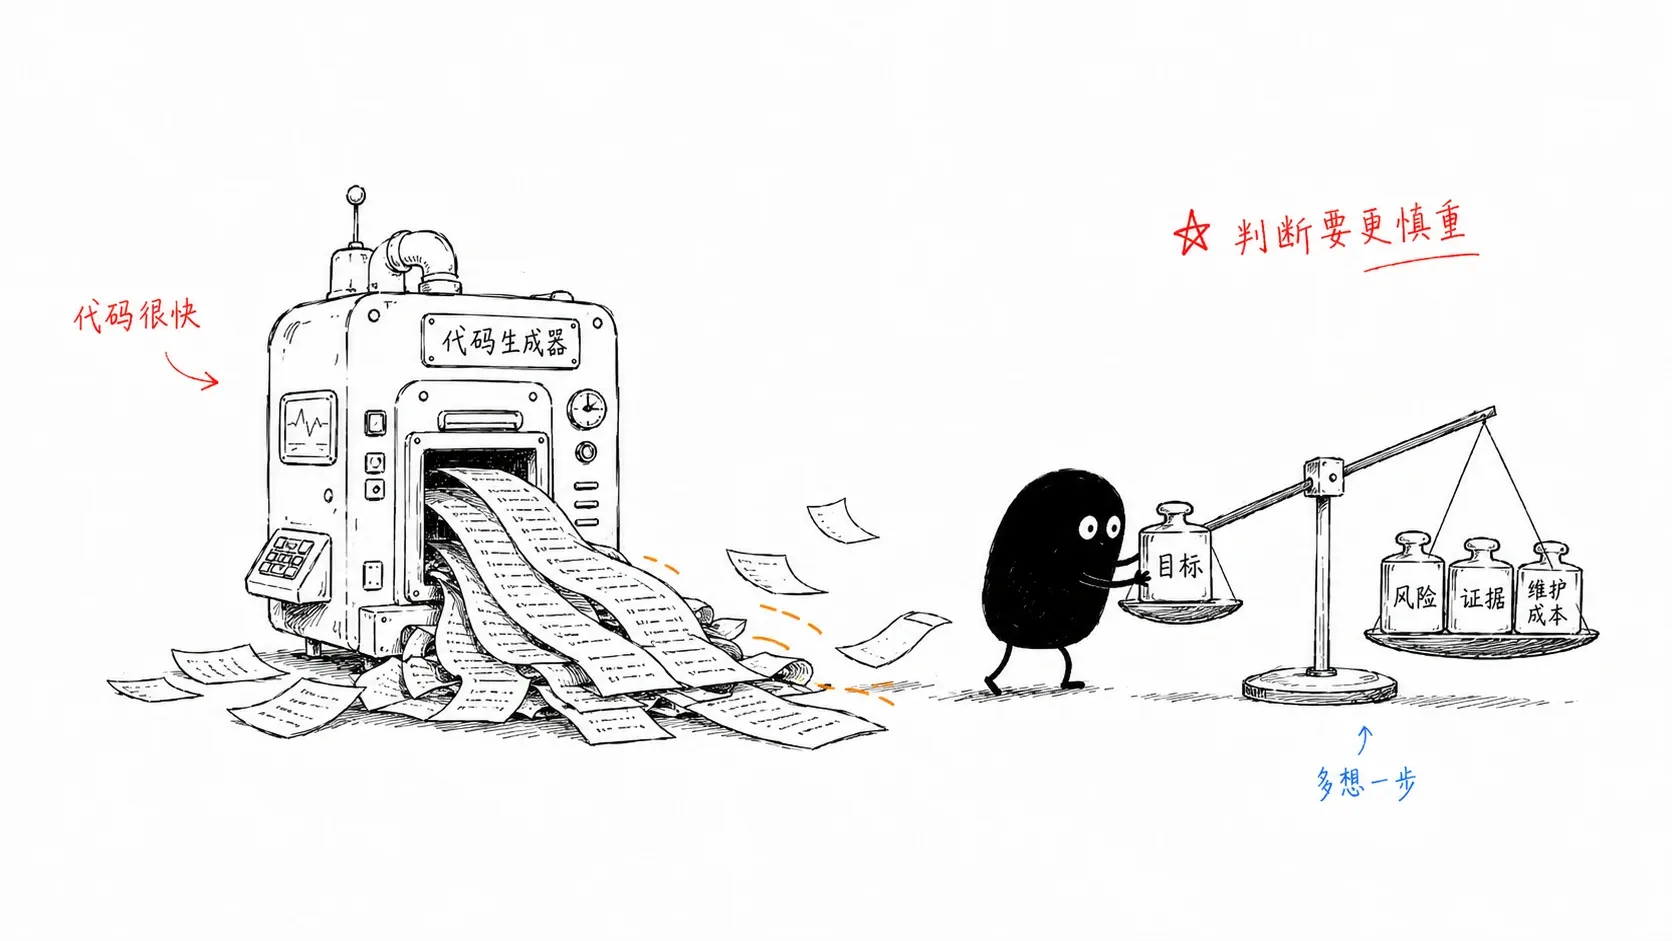
这仍然是我理解 AI Coding 工作流时最重要的一条线,也是我在使用 Coding Agent 时一直保留的人工环节。